使用 Ollama 配置模型
Ollama 是在没有完整 vLLM 或 GPU 栈的情况下运行本地 LLM 的简单方式。Ollama 在端口 11434 上暴露 OpenAI 兼容 API,Semantic Router 可以在首次运行设置或手写 YAML 中将其用作模型后端。
本指南将逐步说明:
- 在主机上安装 Ollama 并拉取模型
- 使 Ollama API 可从 Docker 到达
- 在 Semantic Router 设置控制面板中注册模型
- 激活配置并发送测试请求
Semantic Router 在 vllm-sr serve 期间运行在 Docker 中。名称 host.docker.internal 可以从容器解析主机,但不会使仅监听回环的 Ollama 服务器可到达。在启动 Semantic Router 之前,先完成下面的绑定地址步骤。
前置条件
- 已安装 Semantic Router,并且可以用
vllm-sr serve运行(Linux、macOS,或带 Docker 的 WSL2) - Ollama 安装在运行 Docker 的同一台机器上
- 至少有一个模型所需的磁盘空间(例如,
llama3.2:3b大约 2 GB)
1. 安装 Ollama
从 ollama.com/download 为你的平台安装 Ollama,然后确认 CLI 可用:
ollama --version
在 Linux 上也可以使用安装脚本:
curl -fsSL https://ollama.com/install.sh | sh
Ollama 会自动启动后台服务。它默认监听 http://127.0.0.1:11434,主机可以到达,但 Docker 容器不能。
2. 使 Ollama 可从 Docker 到达
设置 OLLAMA_HOST=0.0.0.0:11434,然后重启 Ollama。设置环境变量的具体方式取决于 Ollama 的安装方式。
在使用标准 systemd 服务的 Linux 上:
sudo systemctl edit ollama.service
添加以下覆盖,保存后重启服务:
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
sudo systemctl daemon-reload
sudo systemctl restart ollama
在 macOS 上,退出 Ollama 应用,设置启动环境,然后重新打开应用:
launchctl setenv OLLAMA_HOST "0.0.0.0:11434"
在 Windows 上,退出 Ollama,添加用户环境变量 OLLAMA_HOST,值为 0.0.0.0:11434,然后从开始菜单重启 Ollama。当前平台特定步骤见 Ollama server FAQ。
对于 WSL,当 Ollama 是 Windows 应用时遵循 Windows 步骤;当服务器本身运行在 WSL 发行版内时,遵循 Linux 步骤。
Ollama 的本地 API 不需要身份验证。绑定到 0.0.0.0 可能让其他主机访问模型列表和生成。将 TCP 端口 11434 限制到容器桥接、主机网关或其他受信任的本地来源,并且永远不要将其发布到不受信任的网络。
3. 拉取模型
从 Ollama library 拉取模型标签。此示例使用 llama3.2:3b,这是一个适合本地测试的小型通用模型:
ollama pull llama3.2:3b
列出本地可用模型:
ollama list
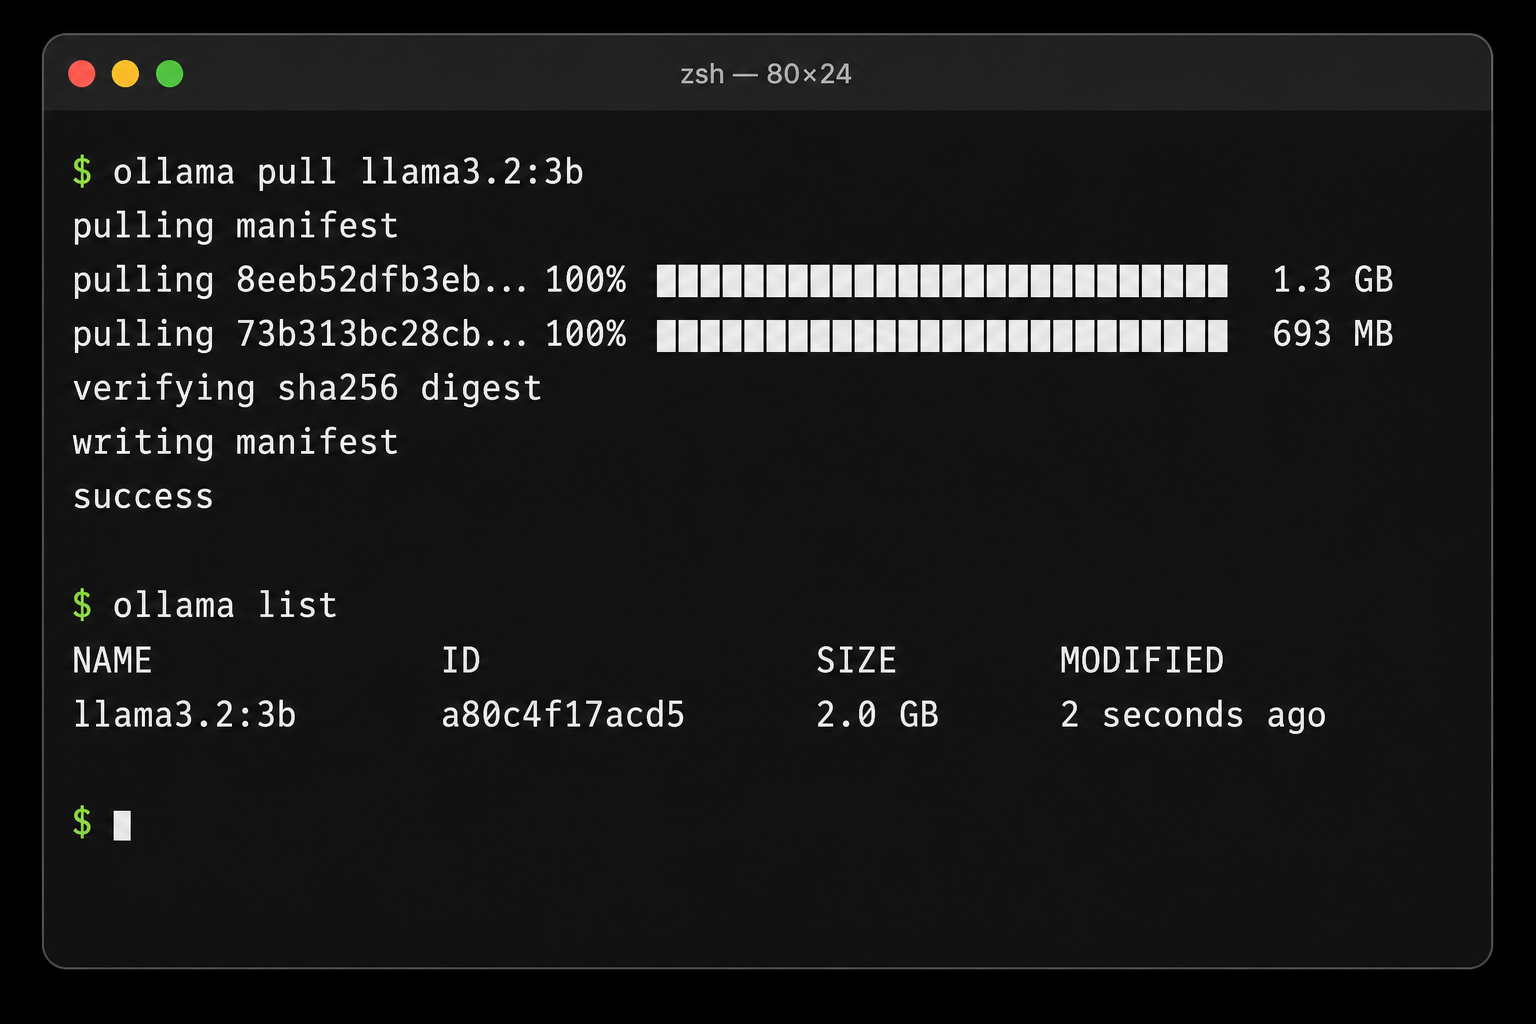
在 Semantic Router 中使用精确的 Ollama 标签(例如 llama3.2:3b、qwen2.5-coder:7b)作为模型名称。Router 会将该名称原样转发给 Ollama。
4. 验证 Ollama 正在提供服务
在打开 Semantic Router 控制面板之前,确认 Ollama 在主机上响应:
curl http://localhost:11434/v1/models
发送一次快速聊天补全:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama3.2:3b",
    "messages": [{"role": "user", "content": "Say hello in one sentence."}]
  }'
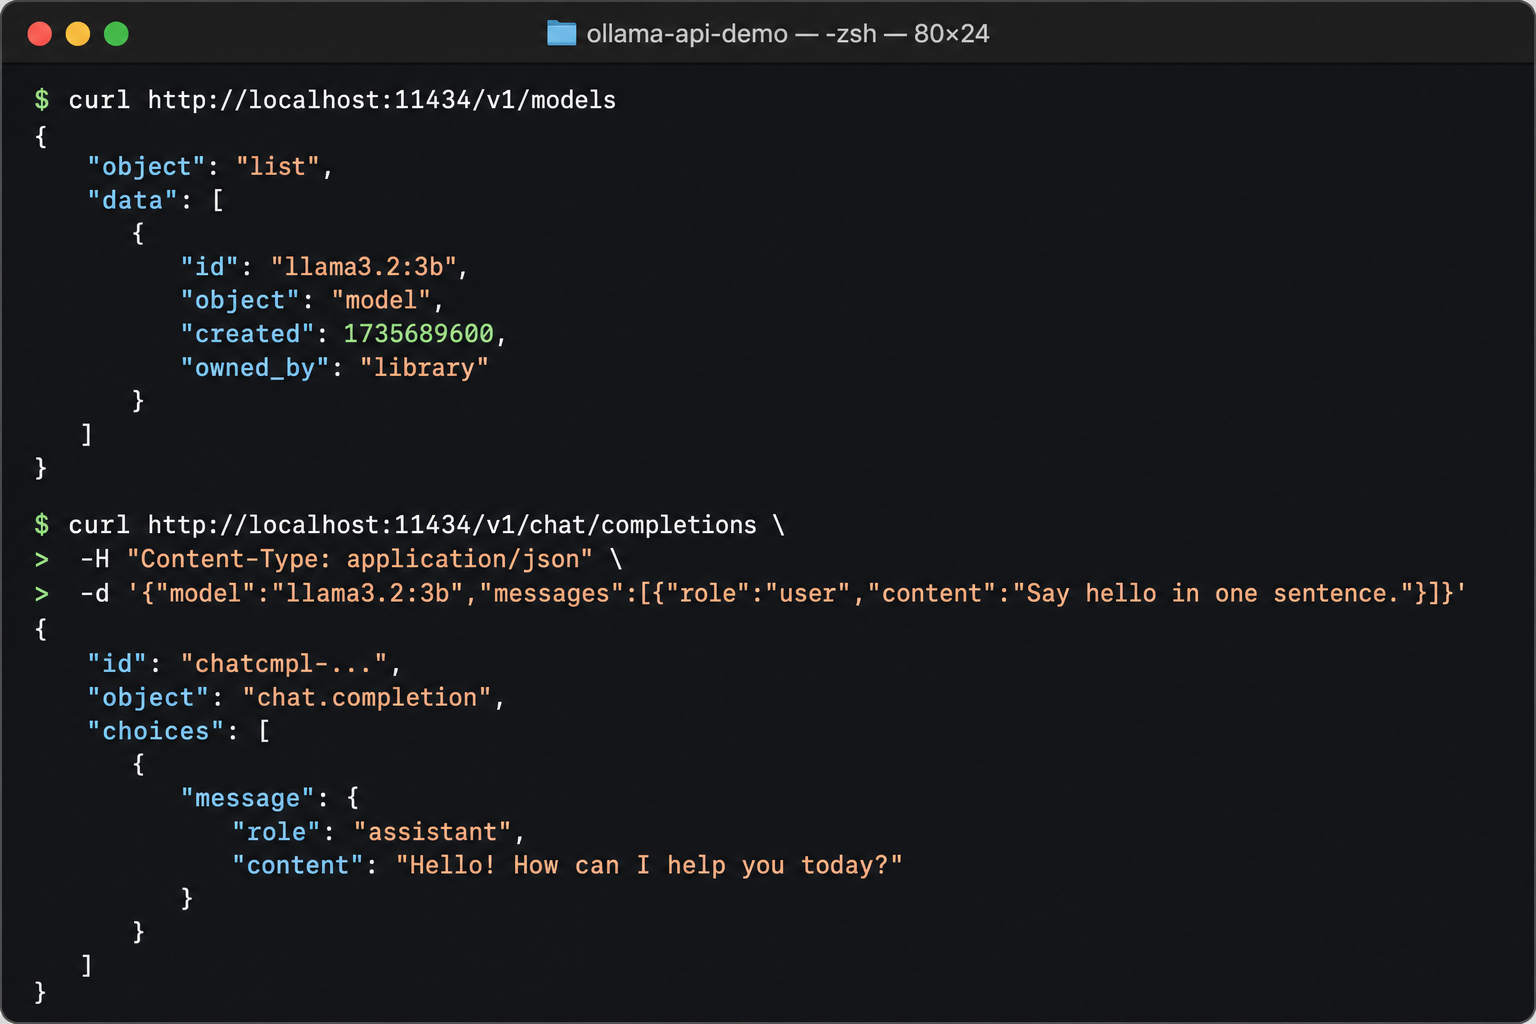
如果任一命令失败,先在主机上修复 Ollama 再继续。Semantic Router 无法到达尚未在端口 11434 上提供服务的后端。
然后验证 Router 容器将使用的地址:
docker run --rm \
  --add-host=host.docker.internal:host-gateway \
  curlimages/curl:8.12.1 \
  http://host.docker.internal:11434/v1/models
如果主机检查成功但容器检查失败,在继续之前重新检查 OLLAMA_HOST 和主机防火墙。
5. 在设置控制面板中配置模型
启动 Semantic Router(或使用安装程序已启动的实例):
vllm-sr serve
如果当前目录中还不存在 config.yaml,控制面板会以设置模式在 http://localhost:8700 打开。
在 Step 1 — Connect model 上注册你的 Ollama 模型:
| 字段 | 值 |
|---|---|
| Model name | 你的 Ollama 标签,例如 llama3.2:3b |
| Provider | Ollama |
| Base URL or host | host.docker.internal:11434 |
| Endpoint label | primary(或任何简短标签) |
| Default | 如果这是你唯一的后端,选择此模型 |
选择 Ollama 会写入 Ollama 后端引用;在本地容器部署中,默认地址是
host.docker.internal:11434。Router 据此识别 Ollama,并用其支持的
max_tokens 字段传递输出 token 上限。如果 Ollama 运行在其他主机,请替换默认地址。
当 model card 校验通过后,点击 Continue。
6. 选择路由并激活
在 Step 2 — Choose routing 上,如果只注册了一个 Ollama 模型,请保留 Single-model baseline。稍后添加更多后端时,可以导入预设或远程配置。
在 Step 3 — Review & activate 上,确认模型摘要,然后点击 Activate configuration。
激活会将 config.yaml 写入当前目录并退出设置模式。Envoy 在端口 8899 启动,并将请求通过 Semantic Router 路由到你的 Ollama 后端。
7. 通过 Semantic Router 测试
通过 Router 代理发送请求:
curl http://localhost:8899/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama3.2:3b",
    "messages": [{"role": "user", "content": "Hello from Semantic Router!"}]
  }'
如果保留了默认的单模型基线,也可以使用自动路由别名:
curl http://localhost:8899/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vllm-sr/auto",
    "messages": [{"role": "user", "content": "Hello from Semantic Router!"}]
  }'
JSON 聊天补全响应表示 Ollama 已正确接入。
YAML 配置(高级)
如果希望直接编辑 YAML 而不是使用控制面板,添加类似这样的模型条目:
version: v0.3

providers:
  defaults:
    model: llama3.2:3b
  models:
    - name: llama3.2:3b
      provider_model_id: llama3.2:3b
      api_format: openai
      backend_refs:
        - name: local-ollama
          endpoint: host.docker.internal:11434
          protocol: http
          provider: ollama
          weight: 100

routing:
  modelCards:
    - name: llama3.2:3b
  decisions:
    - name: default-route
      description: Route all requests to the local Ollama model.
      priority: 100
      rules:
        operator: AND
        conditions: []
      modelRefs:
        - model: llama3.2:3b
          use_reasoning: false
校验并启动服务:
vllm-sr config validate --config config.yaml
vllm-sr serve --config config.yaml
故障排查
Router 无法到达 Ollama
- 在配置中使用
host.docker.internal:11434,而不是localhost:11434。在 Router 容器内,localhost指向容器自身。 - 确认 Ollama 监听的是容器可到达的地址。默认的
127.0.0.1:11434绑定不够;按上文配置OLLAMA_HOST并重启 Ollama。 - 本地运行时会为 Docker 或 Podman 添加
host.docker.internal:host-gateway映射。这提供名称解析和路由,而不是主机回环接口的代理。如果连通性仍然失败,参见容器连通性。 - 确认 Ollama 在主机上响应:
curl http://localhost:11434/v1/models。
找不到模型,或 Ollama 返回 404
- Semantic Router 中的 Model name 必须与 Ollama 标签完全匹配(
llama3.2:3b,而不是llama3.2)。 - 运行
ollama list,如果缺少该标签则拉取:ollama pull <tag>。
第一次请求很慢
- Ollama 按需加载模型。空闲后的第一次请求可能更久,因为权重正在加载到内存。
推理模型(Qwen3 及类似模型)
- 某些推理模型在通过 Ollama 的 OpenAI 兼容端点调用时,会把全部 token 预算花在内部思考上。对于带 Qwen3 风格模型的高级本地设置,参见仓库中的
bench/grounded_fusion/ollama_proxy.py。
下一步
- 在控制面板中添加更多后端,并打开语义路由预设
- 阅读配置指南,了解决策、信号和 model card
- 参见 agentgateway homelab 博文,了解包含本地 Ollama 的多模型设置